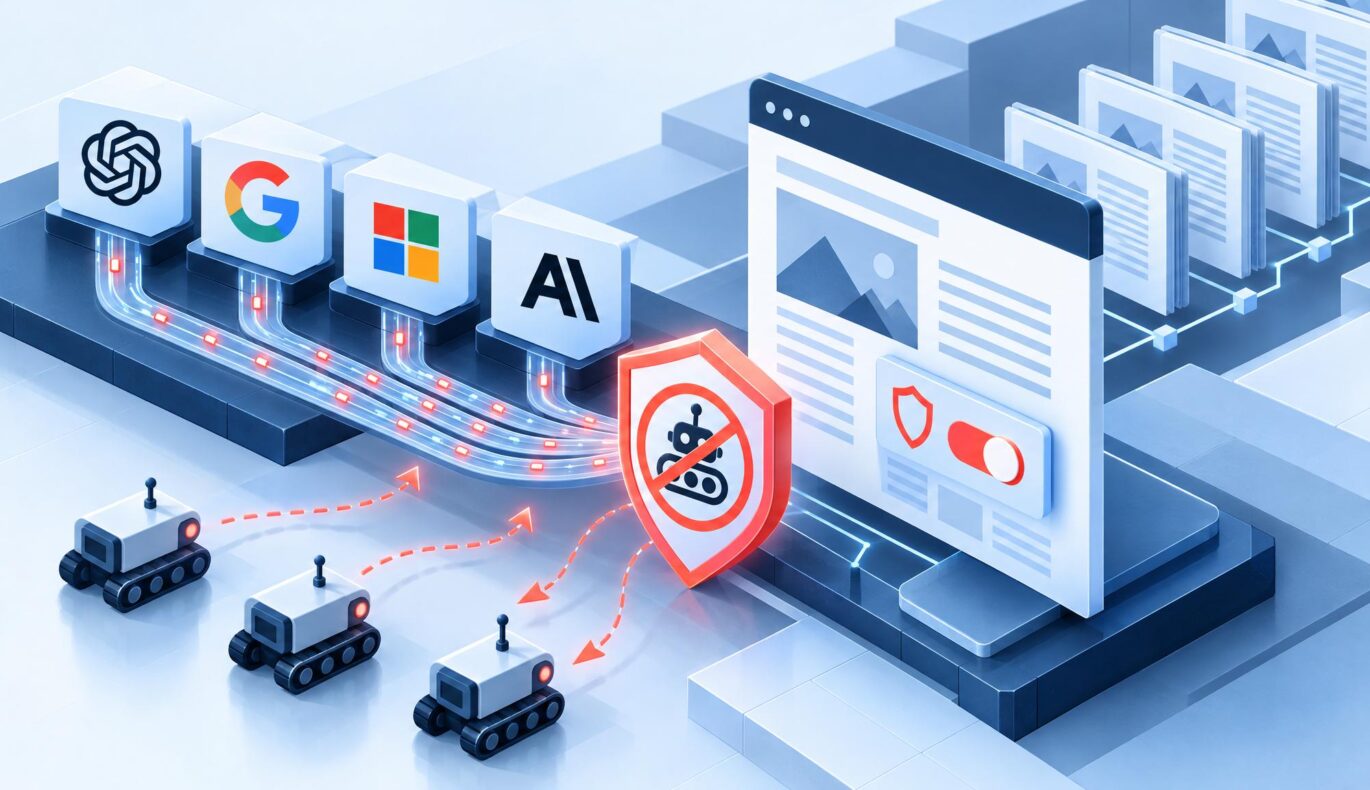
OpenAI, Google, Microsoft y Anthropic afirman que adoptarán un estándar común destinado a permitir a los editores impedir el rastreo por parte de la IA mediante un único ajuste a nivel de sitio web. La propuesta afecta a los propietarios de sitios web, a los desarrolladores de rastreadores y a las empresas de IA: en lugar de configurar las preferencias por separado para cada proveedor, un editor podría publicar una señal común en su robots.txt archivo.
En qué consiste la opción de exclusión voluntaria del scraping mediante IA propuesta
La señal se describe como un “token de política” compartido, propuesto por Kevin Kelley, responsable técnico de estándares en Anthropic, en el marco del Grupo de Trabajo de Ingeniería de Internet (IETF). Se sumaría a los ya existentes robots.txt normas que utilizan los sitios web para indicar si los rastreadores web pueden acceder a su contenido con fines tales como la indexación en motores de búsqueda o el archivo.
Según el informe facilitado, las empresas participantes afirman que adoptarán la nueva norma. El cambio que se plantea es la interoperabilidad: los editores podrían indicar sus preferencias de entrenamiento de la IA una sola vez para varias empresas de IA, en lugar de tener que mantener instrucciones distintas para cada proveedor.
Eso no significa que el sistema ya esté disponible, que cuente con apoyo generalizado o que sea jurídicamente vinculante. El material original no especifica una fecha de puesta en marcha, qué productos de IA leerán la señal en primer lugar, si el token puede distinguir el entrenamiento de la IA de otras formas de scraping, ni cómo se comprobará el cumplimiento.
Por qué esto debería importar a los editores y desarrolladores
Para los editores, un control común podría reducir la carga operativa que supone gestionar las preferencias de los rastreadores en un mercado de la IA en constante evolución. Una pequeña empresa con un sitio web de documentación pública, por ejemplo, podría, hipotéticamente, querer que sus páginas fueran indexadas por los motores de búsqueda convencionales, al tiempo que expresara una preferencia diferente respecto a su uso para el entrenamiento de la IA; el material facilitado no confirma si el token propuesto admite esa combinación concreta.
Los desarrolladores y los equipos de la plataforma tendrían que considerar esta señal como parte de la gestión de los rastreadores: documentar la política del sitio web, probar el resultado robots.txt resultado, y supervisar qué rastreadores lo respetan. La principal ventaja potencial es contar con una convención compartida, en lugar de una serie de ajustes específicos de cada proveedor.
Lo que sigue sin resolverse en relación con la norma
La ubicación del proyecto en robots.txt También pone de manifiesto sus limitaciones. Dichos archivos transmiten las instrucciones del editor, pero la fuente no describe las medidas técnicas de aplicación, las sanciones por incumplirlas ni las soluciones en caso de que el contenido ya haya sido recopilado. Tampoco ofrece detalles sobre si se verían afectados los conjuntos de datos de entrenamiento existentes o el material recopilado anteriormente.
Por el momento, los editores no deben dar por sentado que añadir un nuevo token cambiará de inmediato la forma en que las empresas de IA utilizan sus contenidos. El siguiente paso práctico consiste en seguir la propuesta de la IETF y la documentación del proveedor, y luego verificar la compatibilidad antes de modificar las políticas de los rastreadores en producción.
Fuente: Reportaje original. Este artículo incluye un contexto editorial independiente y un análisis práctico.
Más información sobre la IA: Echa un vistazo a nuestra Últimos artículos sobre automatización y tecnología de IA, o echa un vistazo a soluciones de automatización listas para usar.