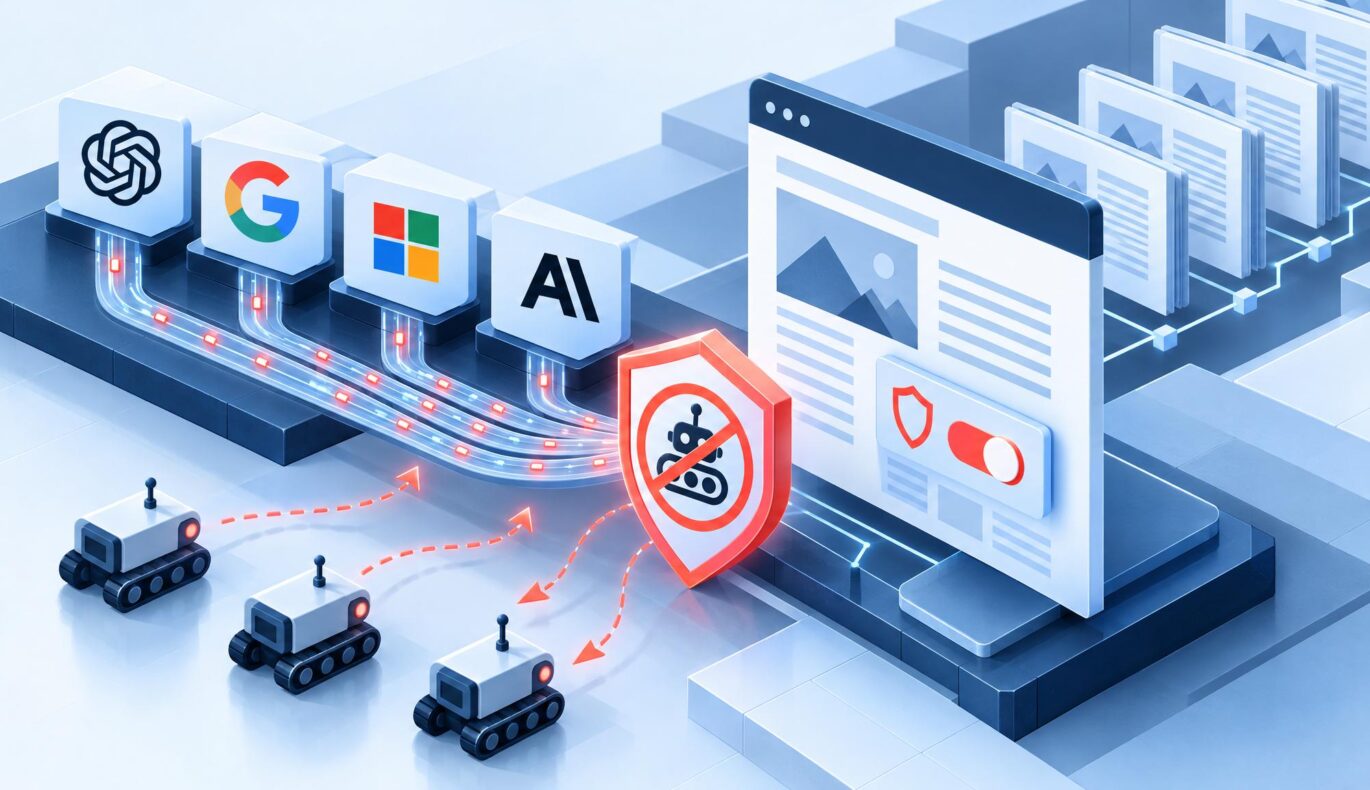
أعلنت شركات OpenAI وGoogle وMicrosoft وAnthropic أنها ستتبنى معيارًا مشتركًا يهدف إلى تمكين الناشرين من رفض استخراج البيانات بواسطة الذكاء الاصطناعي من خلال إعداد واحد على مستوى الموقع الإلكتروني. ويؤثر هذا الاقتراح على مالكي المواقع الإلكترونية ومطوري برامج الزحف وشركات الذكاء الاصطناعي: فبدلاً من تكوين التفضيلات بشكل منفصل لكل مزود، يمكن للناشر نشر إشارة موحدة في robots.txt ملف.
ما الذي يحققه خيار «إلغاء الاشتراك» المقترح فيما يتعلق بجمع البيانات باستخدام الذكاء الاصطناعي
يُوصف هذا الإشارة بأنها “رمز سياسة” مشترك، اقترحه كيفن كيلي، أحد القادة الفنيين المعنيين بالمعايير في شركة «أنثروبيك»، ضمن فريق عمل هندسة الإنترنت (IETF). وسيكون هذا الرمز إلى جانب الرموز الحالية robots.txt القواعد التي تستخدمها مواقع الويب للإشارة إلى ما إذا كان يُسمح لبرامج الزحف إلى الويب بالوصول إلى محتواها لأغراض مثل فهرسة البحث أو الأرشفة.
ووفقًا للتقرير المقدم، تقول الشركات المشاركة إنها ستتبنى المعيار الجديد. ويتمثل التغيير المذكور في قابلية التشغيل البيني: حيث يمكن للناشرين تحديد تفضيلاتهم المتعلقة بتدريب الذكاء الاصطناعي مرة واحدة فقط لتطبيقها على العديد من شركات الذكاء الاصطناعي، بدلاً من الاحتفاظ بتعليمات منفصلة لكل مزود.
وهذا لا يعني أن النظام متاح بالفعل، أو يحظى بدعم عالمي، أو ملزم قانونًا. ولا تحدد المصادر تاريخًا لبدء التشغيل، ولا المنتجات التي تعمل بالذكاء الاصطناعي التي ستقرأ الإشارة أولاً، ولا ما إذا كان الرمز المميز قادرًا على التمييز بين تدريب الذكاء الاصطناعي وأشكال الاستخراج الأخرى، ولا كيفية التحقق من الامتثال.
لماذا ينبغي أن يهتم الناشرون والمطورون بهذا الأمر
بالنسبة للناشرين، يمكن أن يقلل وجود آلية تحكم موحدة من العبء التشغيلي المرتبط بإدارة تفضيلات برامج الزحف في سوق الذكاء الاصطناعي المتغير. فعلى سبيل المثال، قد ترغب شركة صغيرة تمتلك موقعًا عامًا للوثائق، من الناحية النظرية، في أن يتم فهرسة صفحاتها بواسطة محركات البحث التقليدية، مع الإعراب في الوقت نفسه عن تفضيل مختلف بشأن استخدامها في تدريب الذكاء الاصطناعي؛ ولا تؤكد المواد المتوفرة ما إذا كان الرمز المقترح يدعم هذا المزيج بالضبط.
سيتعين على المطورين وفرق المنصات التعامل مع هذه الإشارة كجزء من إدارة برامج الزحف: توثيق سياسة الموقع، واختبار النتائج robots.txt الإخراج، ومراقبة أي برامج الزحف تلتزم به. وتتمثل الميزة المحتملة الرئيسية في وجود معيار مشترك بدلاً من سلسلة من الإعدادات الخاصة بكل مزود على حدة.
ما الذي لا يزال غير محسوم بشأن المعيار
موقع الاقتراح في robots.txt كما يسلط الضوء على محدوديتها. فهذه الملفات تنقل تعليمات الناشر، لكن المصدر لا يصف آليات التنفيذ الفنية، أو العقوبات المفروضة في حالة تجاهلها، أو سبل الانتصاف في حال تم جمع المحتوى بالفعل. كما أنها لا تقدم أي تفاصيل حول ما إذا كانت مجموعات البيانات التدريبية الحالية أو المواد التي تم استخراجها سابقًا ستتأثر بذلك.
في الوقت الحالي، لا ينبغي للناشرين أن يفترضوا أن إضافة رمز جديد ستؤدي على الفور إلى تغيير الطريقة التي تستخدم بها شركات الذكاء الاصطناعي محتواهم. وتتمثل الخطوة العملية التالية في اتباع اقتراح IETF ووثائق المزود، ثم التحقق من الدعم قبل تغيير سياسات برامج الزحف في بيئة الإنتاج.
المصدر: التغطية الصحفية الأصلية. تتضمن هذه القصة سياقاً تحريرياً مستقلاً وتحليلاً عملياً.
المزيد من الرؤى حول الذكاء الاصطناعي: تصفح موقعنا أحدث المقالات حول الأتمتة والذكاء الاصطناعي, ، أو استكشف حلول أتمتة جاهزة للاستخدام.