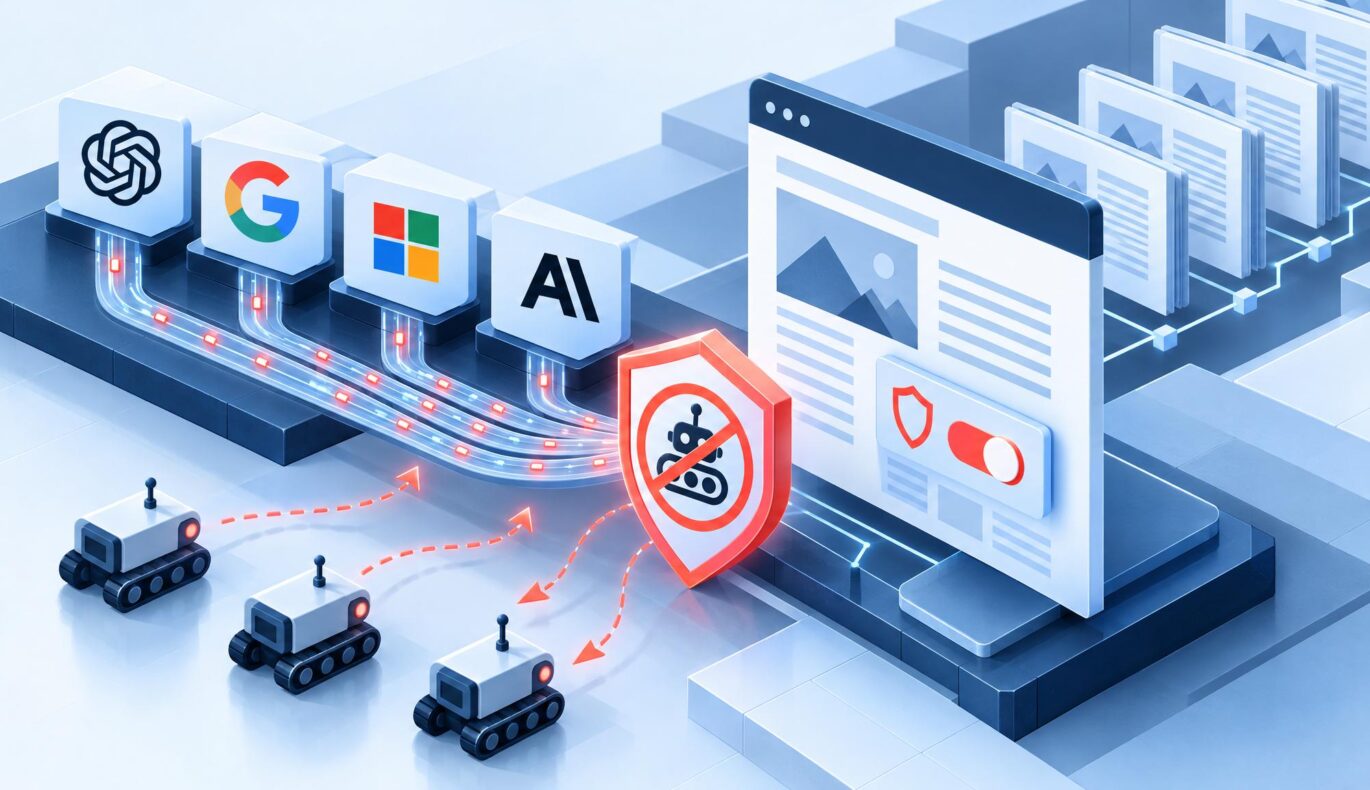
OpenAI, Google, Microsoft et Anthropic ont annoncé leur intention d'adopter une norme commune visant à permettre aux éditeurs de refuser le « scraping » par l'IA grâce à un paramètre unique au niveau du site web. Cette proposition concerne les propriétaires de sites web, les développeurs de robots d'indexation et les entreprises spécialisées dans l'IA : au lieu de configurer des préférences séparément pour chaque fournisseur, un éditeur pourrait diffuser un signal commun dans son robots.txt fichier.
En quoi consiste la possibilité de refus proposée concernant le « scraping » par l'IA ?
Ce signal est décrit comme un “ jeton de politique ” partagé, proposé par Kevin Kelley, responsable technique des normes chez Anthropic, au sein de l'Internet Engineering Task Force (IETF). Il viendrait s'ajouter aux robots.txt des règles que les sites web utilisent pour indiquer si les robots d'indexation sont autorisés à accéder à leur contenu à des fins telles que l'indexation pour les moteurs de recherche ou l'archivage.
D'après le rapport fourni, les entreprises participantes indiquent qu'elles adopteront la nouvelle norme. Le changement annoncé concerne l'interopérabilité : les éditeurs pourraient définir une seule fois leurs préférences en matière d'entraînement de l'IA pour plusieurs entreprises spécialisées dans ce domaine, plutôt que de devoir établir des instructions distinctes pour chaque fournisseur.
Cela ne signifie pas pour autant que le système soit déjà disponible, universellement pris en charge ou juridiquement contraignant. Le document source ne précise pas de date de déploiement, quels produits d’IA détecteront le signal en premier, si le jeton permet de distinguer l’entraînement des IA d’autres formes de « scraping », ni comment la conformité sera vérifiée.
Pourquoi les éditeurs et les développeurs devraient s'y intéresser
Pour les éditeurs, un contrôle commun pourrait alléger la charge opérationnelle liée à la gestion des préférences des robots d'indexation sur un marché de l'IA en constante évolution. Une petite entreprise disposant d'un site de documentation public, par exemple, pourrait théoriquement souhaiter que ses pages soient indexées par les moteurs de recherche classiques tout en exprimant une préférence différente concernant leur utilisation pour l'entraînement des IA ; les informations fournies ne permettent pas de confirmer si le jeton proposé prend en charge cette combinaison précise.
Les développeurs et les équipes chargées des plateformes devraient considérer ce signal comme faisant partie intégrante de la gestion des robots d'indexation : documenter la politique du site, tester le résultat robots.txt de la sortie, et de vérifier quels robots d'indexation la respectent. Le principal avantage potentiel réside dans l'adoption d'une convention commune plutôt que d'une série de paramètres propres à chaque fournisseur.
Ce qui reste à régler concernant la norme
L'emplacement du projet à robots.txt met également en évidence ses limites. Ces fichiers transmettent les instructions d’un éditeur, mais la source ne décrit pas les mesures techniques de mise en œuvre, les sanctions en cas de non-respect de ces instructions, ni les recours possibles lorsque le contenu a déjà été collecté. Elle ne précise pas non plus si les ensembles de données d’entraînement existants ou les contenus déjà extraits seraient concernés.
Pour l'instant, les éditeurs ne doivent pas partir du principe que l'ajout d'un nouveau jeton modifiera immédiatement la manière dont les entreprises spécialisées dans l'IA utilisent leur contenu. La prochaine étape concrète consiste à suivre la proposition de l'IETF et la documentation des fournisseurs, puis à vérifier la prise en charge avant de modifier les politiques relatives aux robots d'indexation en production.
Source : Reportage original. Cet article propose un contexte rédactionnel indépendant et une analyse concrète.
Plus d'informations sur l'IA : Parcourez notre Derniers articles sur l'automatisation et les technologies liées à l'IA, ou découvrir solutions d'automatisation prêtes à l'emploi.