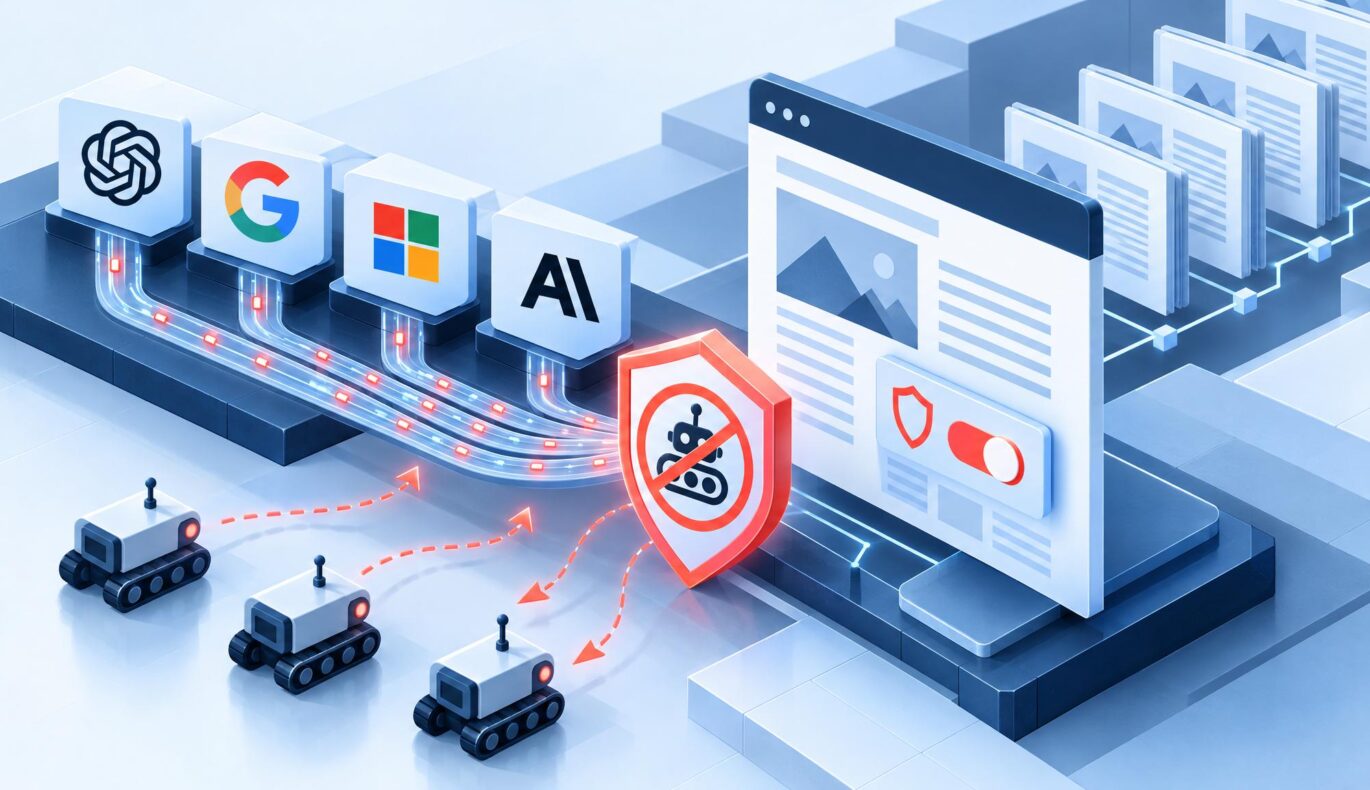
OpenAI, Google, Microsoft i Anthropic zapowiadają, że wprowadzą wspólny standard, który ma umożliwić wydawcom rezygnację z indeksowania treści przez sztuczną inteligencję za pomocą jednego ustawienia na poziomie strony internetowej. Propozycja ta dotyczy właścicieli stron internetowych, twórców robotów indeksujących oraz firm zajmujących się sztuczną inteligencją: zamiast konfigurować preferencje osobno dla każdego dostawcy, wydawca mógłby umieścić na swojej stronie wspólny sygnał w robots.txt plik.
Na czym polega proponowana możliwość rezygnacji ze zbierania danych przez sztuczną inteligencję
Sygnał ten opisywany jest jako wspólny “token zasad”, zaproponowany przez Kevina Kelleya, kierownika ds. standardów w firmie Anthropic, w ramach Internet Engineering Task Force (IETF). Miałby on funkcjonować równolegle z istniejącymi robots.txt zasady, na podstawie których strony internetowe informują, czy roboty indeksujące mogą uzyskać dostęp do ich treści w celach takich jak indeksowanie w wyszukiwarkach lub archiwizacja.
Zgodnie z przedłożonym raportem uczestniczące w projekcie firmy deklarują, że wdrożą nowy standard. Główną zmianą jest interoperacyjność: wydawcy będą mogli jednorazowo określić swoje preferencje dotyczące szkolenia modeli AI dla wielu firm zajmujących się sztuczną inteligencją, zamiast przygotowywać oddzielne instrukcje dla każdego dostawcy.
Nie oznacza to jednak, że system jest już dostępny, powszechnie obsługiwany ani prawnie wiążący. Materiał źródłowy nie podaje daty wdrożenia, nie precyzuje, które produkty oparte na sztucznej inteligencji jako pierwsze będą odczytywać ten sygnał, nie wyjaśnia, czy token potrafi odróżnić proces uczenia się sztucznej inteligencji od innych form zbierania danych, ani w jaki sposób będzie sprawdzana zgodność z przepisami.
Dlaczego wydawcy i twórcy gier powinni się tym zainteresować
Dla wydawców wspólny mechanizm kontroli mógłby zmniejszyć obciążenie operacyjne związane z zarządzaniem preferencjami robotów indeksujących na zmieniającym się rynku sztucznej inteligencji. Na przykład mała firma posiadająca publiczną stronę z dokumentacją mogłaby hipotetycznie chcieć, aby jej strony były indeksowane przez tradycyjne wyszukiwarki, jednocześnie wyrażając inne preferencje dotyczące ich wykorzystania do szkolenia modeli sztucznej inteligencji; udostępnione materiały nie potwierdzają, czy proponowany token obsługuje właśnie taką kombinację.
Programiści i zespoły odpowiedzialne za platformy musieliby traktować ten sygnał jako element zarządzania robotami indeksującymi: udokumentować zasady obowiązujące w witrynie, przetestować wynikowe robots.txt wynik oraz monitorować, które roboty indeksujące się do niego stosują. Główną potencjalną zaletą jest wspólna konwencja, a nie szereg ustawień specyficznych dla poszczególnych dostawców.
Co pozostaje nierozstrzygnięte w odniesieniu do tej normy
Lokalizacja projektu w robots.txt podkreśla również jego ograniczenia. Pliki te zawierają wytyczne wydawcy, jednak dokument źródłowy nie opisuje technicznych środków egzekwowania, kar za ich nieprzestrzeganie ani środków zaradczych w przypadku, gdy treści zostały już zebrane. Nie zawiera on również żadnych szczegółowych informacji na temat tego, czy dotyczy to istniejących zbiorów danych szkoleniowych lub materiałów zebranych wcześniej.
Na razie wydawcy nie powinni zakładać, że dodanie nowego tokenu natychmiast zmieni sposób, w jaki firmy zajmujące się sztuczną inteligencją wykorzystują ich treści. Praktycznym kolejnym krokiem jest postępowanie zgodnie z propozycją IETF i dokumentacją dostawcy, a następnie sprawdzenie, czy dana funkcja jest obsługiwana, zanim wprowadzi się zmiany w zasadach działania robotów indeksujących w środowisku produkcyjnym.
Źródło: Oryginalne relacje. Artykuł ten zawiera niezależny kontekst redakcyjny oraz praktyczną analizę.
Więcej informacji na temat sztucznej inteligencji: Zapoznaj się z naszą ofertą najnowsze artykuły dotyczące automatyzacji i technologii opartych na sztucznej inteligencji, albo zapoznaj się z gotowe do użycia rozwiązania automatyzacyjne.